실제 로봇 4개 조작 조건에서 평균 성공률 78.4%…엔비디아·피지컬 인텔리전스 비교 모델 상회
인공지능·기계학습 분야 최고 권위 국제학술대회 NeurIPS 2026 논문 채택
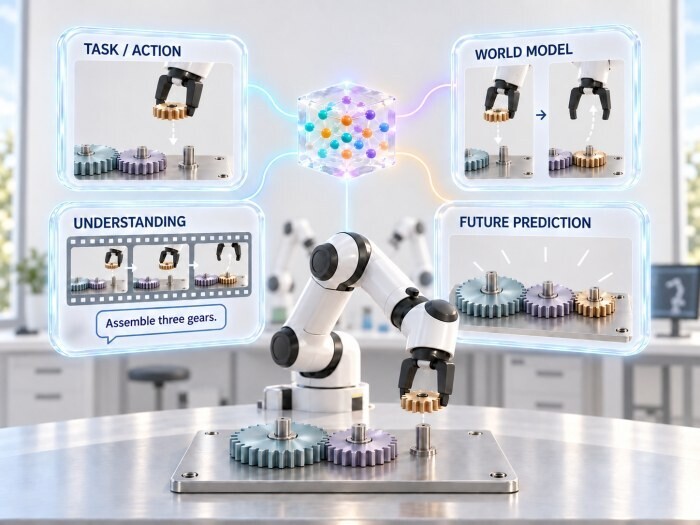 |
| ▲사람의 지시 이해, 미래 장면 예측, 행동 생성을 하나의 모델로 통합한 로봇 AI 'Dynin-Robotics' 개념 이미지 |
서울대학교 공과대학 전기·정보공학부 도재영 교수 연구팀(AIDAS 연구실)이 언어, 이미지, 영상, 로봇 행동을 하나의 모델에서 함께 다루는 로봇 파운데이션 모델 ‘Dynin-Robotics’를 개발했다. 파운데이션 모델은 다양한 데이터를 학습해 여러 작업에 활용할 수 있도록 만든 기반 AI 모델을 뜻한다.
Dynin-Robotics는 사람의 지시와 카메라 영상을 바탕으로 로봇의 움직임을 생성한다. 특정 행동을 했을 때의 다음 장면이나 작업을 마친 뒤의 목표 장면을 이미지로 예측하고, 이를 행동 생성과 선택에 활용할 수도 있다. 실제 로봇을 이용한 네 가지 조작 조건 평가에서는 평균 성공률 78.4%로, 이번 실험에 사용된 엔비디아와 미국 로봇 AI 기업 피지컬 인텔리전스의 비교 모델을 웃돌았다.
연구 결과를 담은 논문은 인공지능·기계학습 분야 최고 권위의 국제학술대회 NeurIPS 2026에 채택됐으며, 오는 12월 발표될 예정이다.
로봇 하드웨어는 빠르게 발전하고 있지만, 낯선 환경에서 새로운 지시를 이해해 작업을 수행하는 일은 여전히 어려운 과제다. 정해진 조건에서 익힌 동작을 반복하는 것과 달리, 실제 현장에서는 물체의 위치와 모양, 사람의 요청이 매번 달라지기 때문이다. 예를 들어 "책상 위의 컵을 서랍 안에 넣고 닫아라"라는 지시를 수행하려면 컵과 서랍의 위치를 파악하고, 컵을 옮긴 뒤 서랍을 닫는 여러 단계의 행동을 결정해야 한다.
최근에는 ChatGPT와 같은 대규모 언어모델의 언어 이해 능력을 로봇 제어에 활용하거나, 영상 생성 모델로 미래 장면을 예측하는 연구가 활발하다. 연구팀은 사람의 지시를 이해하는 능력과 행동 결과를 예측하는 능력을 로봇의 움직임 생성에 함께 활용하기 위해, 이들 기능을 하나의 모델로 통합했다.
이번 기술은 연구팀이 앞서 개발한 옴니모달 AI 모델 'Dynin-Omni'를 로봇 제어로 확장한 성과다. 옴니모달 AI는 언어, 이미지, 영상, 음성 등 서로 다른 형태의 정보를 하나의 모델에서 함께 이해하고 생성하는 인공지능을 말한다. 연구팀은 여기에 로봇 행동 데이터를 결합해 현실에서 물체를 옮기거나 쌓는 등의 작업을 수행하는 피지컬 AI 모델을 설계했다.
Dynin-Robotics의 핵심은 지시와 장면을 이해하고, 행동 결과를 예측하며, 실제 움직임을 생성하는 기능을 함께 학습한다는 점이다. 로봇의 작업 영상을 바탕으로 수행한 일을 문장으로 설명할 수도 있다. 연구팀은 '과일 고르기'와 '꽃 꽂기' 시뮬레이션에서 이러한 통합 학습의 효과를 확인했다. 이해·예측·행동 생성을 함께 학습한 모델은 행동 생성만 학습한 모델보다 새로운 표현의 지시를 더 잘 수행했다. "장미를 꽂아"처럼 대상을 직접 지목하는 지시뿐 아니라 "사랑을 상징하는 꽃을 꽂아"처럼 의미를 간접적으로 전달하는 지시에도 대응했다.
미래 장면 예측은 로봇이 어떤 행동을 할지 결정하는 데 활용된다. 사람이 물건을 옮기기 전에 옮겨 놓을 위치와 결과를 떠올리는 것처럼, 로봇도 현재 장면과 지시를 바탕으로 작업 후의 모습을 이미지로 그릴 수 있다. 연구팀은 예측한 목표 장면을 참고해 행동을 생성하거나, 후보 동작들을 평가해 더 적절한 행동을 선택하는 방법을 구현했다.
행동 생성에 필요한 계산 시간도 줄였다. 연구팀은 이어지는 여러 동작에 필요한 정보를 묶어 병렬로 예측하는 방식을 적용했다. 계산 과정에서 반복해서 사용하는 정보도 재활용해 로봇의 다음 동작을 생성하는 효율을 높였다. 모델 내부의 행동 생성 속도는 개선 전의 최대 약 29.2배로 향상되었으며, 피지컬 인텔리전스의 ‘π0.5’ 대비 최대 약 36.6배 빠른 속도를 기록했다.
실제 로봇 실험에서는 과일 옮기기, 색상별 블록 분류, 순서 제한 없는 블록 쌓기, 지정된 색상 순서에 따른 블록 쌓기 등 네 가지 조작 조건을 평가했다. 네 조건의 성공률을 평균한 결과, 엔비디아의 'GR00T N1.6'은 73.0%, 'Cosmos Policy'는 73.6%, 피지컬 인텔리전스의 'π0.5'는 76.9%를 기록했다. Dynin-Robotics는 78.4%로 이번 평가에 사용된 비교 모델 가운데 가장 높은 평균 성공률을 보였다.
이번 기술은 물류 현장의 물체 분류와 이송, 제조 공정의 부품 취급처럼 사람의 지시와 주변 상황을 함께 고려해야 하는 작업에 활용될 수 있다. 다만 이번 성과는 시뮬레이션과 정해진 실제 로봇 실험 환경에서 검증한 결과다. 산업 현장에 적용하려면 더 다양한 물체와 작업 환경에서 성능을 확인해야 한다.
연구팀은 Dynin 파운데이션 모델 시리즈를 바탕으로 제조·물류 현장의 부품 취급, 조립, 물체 분류 등을 대상으로 적용 가능성을 검증할 계획이다. 제조·의료 분야의 데이터와 요구에 맞춘 추가 학습을 통해 분야별 특화 모델로도 고도화할 예정이다. 이를 위해 로봇 손을 이용한 정밀 조작, 촉각·힘 센서를 활용한 접촉 상태 파악, 새로운 작업과 환경에 빠르게 적응하는 학습 기술을 개발하고 있다. 서울대학교 의과대학 연구진과는 수술 보조 로봇과 소화기 내시경 로봇 등에 AI를 활용하는 공동연구도 추진하고 있다.
연구팀은 사람이 제시한 목표를 여러 단계의 작업으로 나누고, 로봇에 작업을 맡긴 뒤 결과를 확인해 다음 행동을 조정하는 AI 에이전트 연구도 함께 추진한다. 예를 들어 "식탁을 치워 줘"라는 요청을 받으면 필요한 작업을 나눠 로봇에 전달하고, 결과를 확인해 실패한 작업은 다른 방법으로 다시 시도하도록 하는 방식이다. 연구팀은 이 과정에서 축적한 성공·실패 경험을 활용해 작업 계획과 수행 능력을 지속적으로 개선하는, 이른바 ‘쓸수록 똑똑해지는 로봇’을 구현할 계획이다.
연구를 지도한 도재영 교수는 "이번 연구는 로봇이 무엇을 해야 하는지, 움직인 뒤 주변이 어떻게 달라질지, 실제로 어떤 행동을 할지를 하나의 모델에서 함께 다룬다는 점에서 의미가 있다"며 "Dynin-Omni의 통합 AI 기술을 로봇 제어로 확장한 이번 성과를 바탕으로, 시험 환경을 넘어 실제 환경에서 사람의 지시를 이해하고 어려운 작업을 수행하는 로봇 지능으로 발전시켜 나가겠다"고 말했다.
이번 연구는 한국연구재단 이공분야 기초연구사업(우수신진)의 지원을 받아 수행됐다.
피앤피뉴스 / 마성배 기자 gosiweek@gmail.com
[저작권자ⓒ 피앤피뉴스. 무단전재-재배포 금지]